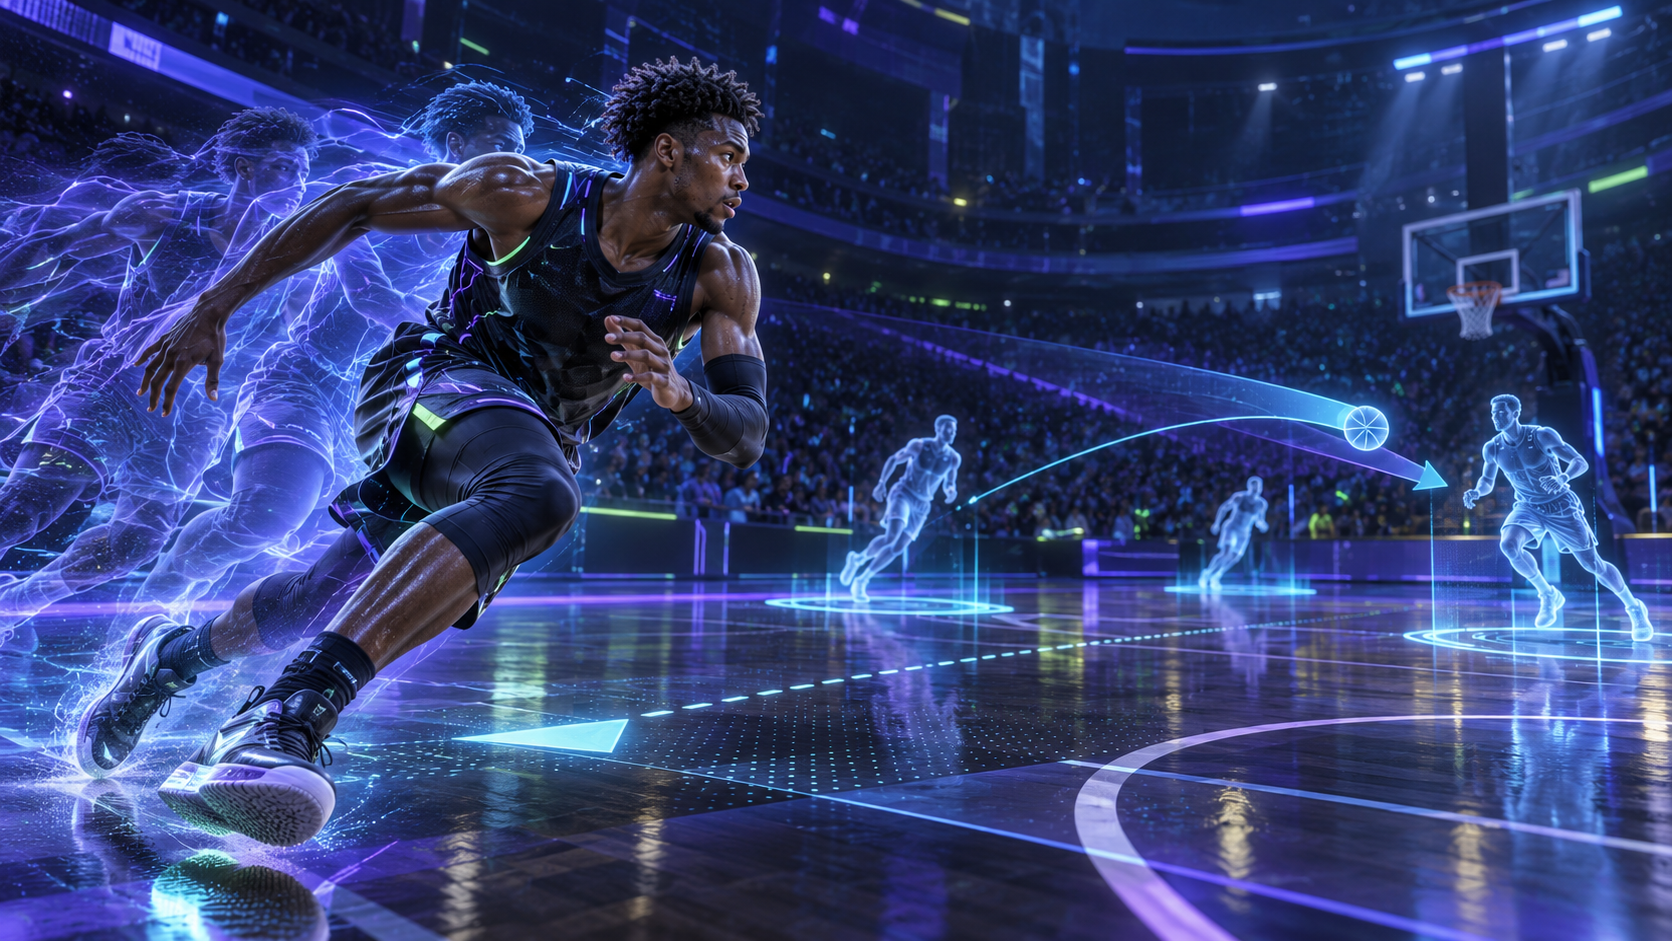
你连续三次沿边路下底,第四次抬头时,队友提前跑向后点。如果这是固定脚本,下一局也会一样;如果它真的学会了你的习惯,它还应该知道什么时候不能继续赌这条线路。
脚本为什么容易被摸透
传统NPC依靠状态机、行为树和预设权重。它们执行稳定,适合高速比赛,却容易形成可重复的空当:玩家发现一种传球总能骗过防线后,比赛变成刷同一道题。随机提高难度也不够,因为毫无理由的抢断只像作弊。
记忆应落在比赛事实上
AI角色可以记录玩家更常使用哪只脚、是否喜欢回传、领先时是否保守,但记忆必须有边界。最近三场的习惯比一年前的动作更有参考价值;不同位置的队友也不该共享一套“全知”视角。一个前锋看到的是出球机会,后卫看到的是回防风险。差异化信息能产生更可信的个性。
快反应交给规则,慢判断交给模型
足球射门窗口、篮球协防和网球接发球不能等长篇语言推理。近年的游戏AI实践显示,较快的行为层与较慢的对话、计划层可以分工。NVIDIA公开的AI同伴案例就把实时动作和较复杂的推理分开。迁移到体育游戏时,模型更适合选战术意图、解释失误和调整长期偏好,逐帧碰撞仍需确定性的游戏系统。
队友不必永远听话
若AI队友对每条指令都照做,它只是一个语音菜单;若总自行决定,它又破坏玩家的控制感。关键是让分歧可读:他为什么没有前插,是越位风险、体力不足,还是识别到对手在封堵?允许玩家在赛后修改战术原则,比在比赛中反复喊“听我的”更有效。
个性也要承担后果
一个擅长远射的虚拟运动员可以更早寻找射门空间,但不能在每次控球时盲射;一位急躁的后卫可能上抢过猛,却能通过训练改变习惯。角色成长要和可观察的比赛事件相连。仅让角色多说几句俏皮话,无法让玩家相信它拥有赛场人格。
目前仍是设计命题
球盟会AI竞技讨论的不是一个已经成熟的“万能球员”。模型成本、响应时间、比赛公平性和内容审核都限制落地。球盟会大模型或球盟会模型在这里指向一类研究问题:怎样让模型理解运动情境,并在可验证规则内做出有差异的判断。
记忆也要允许忘记
角色如果永久保存每个细节,会把偶然失误放大成固定标签。更合理的是区分短期比赛状态、数周内的战术习惯和玩家明确保存的长期偏好。队友可以说“最近你更常往右路传”,却不应把一次冲动犯规当成你的性格。玩家也应该知道哪些内容被记住,并能清除不准确的推断。
让模型接受赛场约束
生成式角色可能说出漂亮的战术,却未必能在规则时间内完成动作。游戏应把可行动作、体力、视野、越位线和战术职责作为硬约束,再让模型在有限选择里体现个性。开发团队还需要记录角色为何做出决定,用大量重复比赛检查是否出现不公平的“预知”与无法解释的突然失常。可信的AI运动员要先是合格的游戏角色。
如何验证队友真的更好
评价AI运动员不能只截取一段会聊天的演示。应反复测试相同局面下的跑位质量、长期配合是否改善、面对陌生打法能否适应,以及失败时是否给出一致解释。玩家的主观信任也要和比赛统计一起观察:队友很强,却让玩家觉得自己只是旁观者,同样是设计失败。